分镜
Coopanion / Cortico 的 World:把视频变成可引用的分镜宫格图,附一份带时间码的清单。
本页所有截图与数字都是在本机真跑出来的(Windows 11 · Coopanion 0.2.17 · 同一支 B 站视频 0–60s)。
它能干什么
一支视频丢进来,出来一张分镜宫格图和一份带时间码的清单:每个格子是一个镜头,标着编号和时间范围,可以直接引用「cell 7 = 00:12.76–00:31.40」。
格子按镜头的稠密程度分配大小:一个 20 秒的长镜头给整幅宽,一串 0.3 秒的蒙太奇缩成 1/8 格。所以一张图能装下几十个镜头,又不会为了快剪白白浪费 token。
四个工具,各管一段:
| 工具 | 干什么 | 什么时候用 |
|---|---|---|
video_probe | 只读文件头:多长、多大、有没有字幕轨 | 动手之前先看看这片子值不值得读 |
video_storyboard | 出宫格图 + 时间码清单,带本地转写与硬字幕 OCR | 想快速看懂一支片子、写摘要、做解说稿 |
video_locate | 只查台词,不取帧,纯文本返回 | 「这片子哪一秒说到了 X」 |
video_zoom | 把某一格那几秒放大重读 | 字幕、人名、小字看不清时 |
一个真数:一支 24 分钟影视解说,37 张图、14,208 token 就能把全片过一遍;同一支片子改用上游默认的切点检测,是 94 张图、36,096 token(1440 秒全片,分五段跑,两组参数相同)。
安装(从本机目录)
先完全退出 Coopanion,把仓库目录复制或 junction 到扩展目录,然后在
extensions/package.json 的 dependencies 里加一行:
# 1) 放进扩展目录
%LOCALAPPDATA%\Programs\Coopanion\data\extensions\node_modules\cortico-world-storyboard

# 2) extensions\package.json 里加依赖
"cortico-world-storyboard": "link:<path-to-this-repo>"

# 3) 启动 Coopanion → 设置 → World → 「分镜」→ 启用
外部程序不用手工装:服务页「一键安装(small)」分五项处理(whisper 运行时 / 模型 / Python venv / wheel 缓存 / 离线 pip),已存在的逐项跳过。OCR 需要 Python 3.11–3.13——这个 Python 只为装 rapidocr 用;可以自己装,也可以用别的方式装 rapidocr。
最常用的三条用法
// ① 幻灯片 / 讲课:关掉积分伪切点,一格一句话
{ "input": "D:/media/lecture.mp4", "integral": false }

// ② 底部有硬字幕的片子:用自带检测器 + 复用扫描结果
{ "input": "D:/media/bilibili.mp4", "detect": "own", "precomputed": "auto" }

// ③ 只要图、不要台词(最快)
{ "input": "D:/media/clip.mp4", "transcript": "off" }
input 可以贴完整链接、b23.tv 短链(QQ 卡片里的短链也行)或本地路径;
裸 BV 号不行(会被当成本地文件名交给 ffprobe)。
1. 积分伪切点:开 vs 关
同一支视频(0–60s)、同一套参数,只切 integral。true 时会在长镜头内部
按“画面变化量累积”补采样帧,这些时刻不是真切点,于是多出重复格。
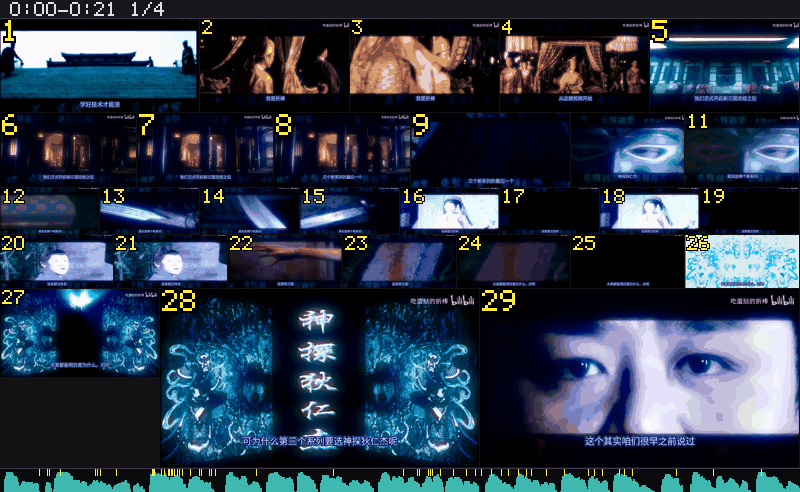
integral: true(默认)· 69 帧 · 9 个伪切点 · 4 张图 · 4.8 s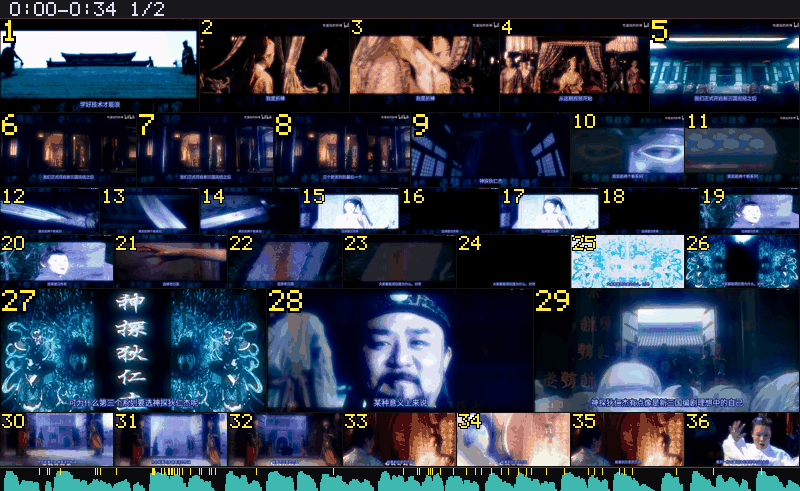
integral: false · 58 帧 · 0 个伪切点 · 2 张图 · 4.3 s(真切点仍是 58 个,一个没少)2. 切点检测:upstream vs own
同一支视频。上游检测对底部硬字幕敏感,字幕一换就被当成切点;detect:"own" 先裁掉底部字幕带,
再做直方图差 + 三点一致性 + 短镜头合并。
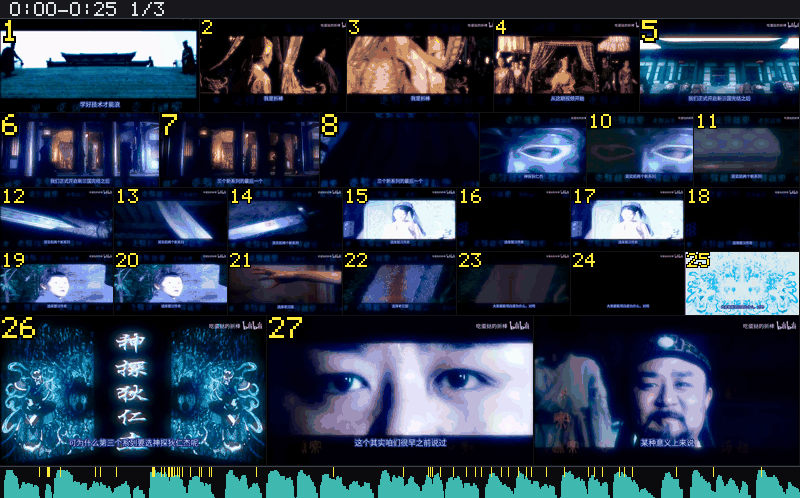
detect: "upstream" · 54 切点 / 65 帧 / 3 张图 · 3.5 s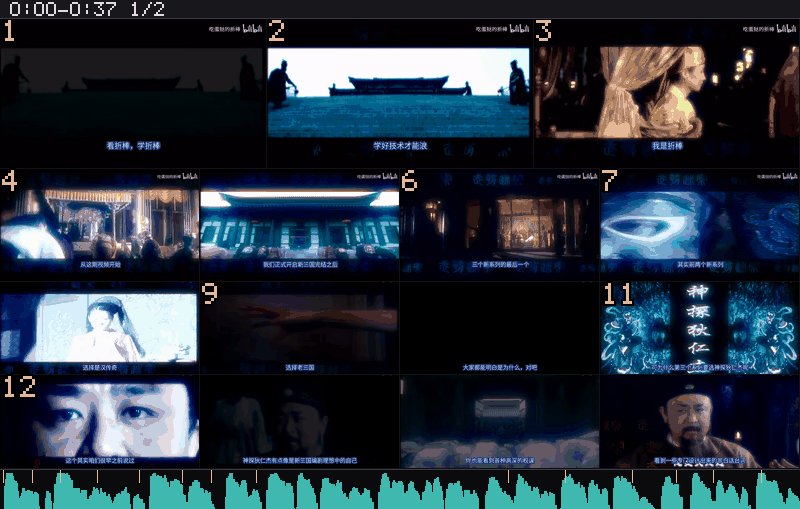
detect: "own" · 14 切点 / 24 帧 / 2 张图 · 1.8 s3. 分析资产复用(precomputed)
第一次扫描落盘(miss→built),第二次同一个窗口直接读盘(hit),不再解码视频。
| 调用 | 状态 | 耗时 | 切点 |
|---|---|---|---|
| 第 1 次 | miss→built | 1.8 s | 14 |
| 第 2 次 | hit | 1.0 s | 14(完全一致) |
窗口越大差距越明显:整片分析一次之后,换格数、换档位、换窗口都只是重新拼图。
4. OCR 把 ASR 错字对齐到画面上实际写的字
同一段 0–60s、detail: "high":ocr: false 13.3 s;ocr: true 31.4 s,
回执是 ocr: corrected 5 lines / 14 chars (engine=rapidocr, conf≥0.85)。
这一节留了一次**真实的 bug 复盘**:它最初把「神探」改成了「神判」,后来定位、修掉、并用回归断言锁住。
修前 vs 修后
| 修前 | 修后 | |
|---|---|---|
| 纠正行数 / 字数 | 5 行 / 14 字 | 5 行 / 14 字 |
| 完全正确(逐字一致) | 2 / 5 | 3 / 5 |
| 部分正确(替换对、漏首尾字) | 1 / 5 | 2 / 5 |
| 错(false correction) | 2 / 5(都是 探 → 判) | 0 |
| 字级一致 | 61 / 67 | 63 / 67 |
核心结论是“错的行从 2 降到 0”:5 行里 3 行完全正确、2 行部分正确(漏了画面上的首尾字,只能靠 A2 标记,不该硬补)。 加严规则(票差 ≥2 才改)让 45.0s 那行少改一个字,字级从 64 掉到 63——这是“宁可少改”的代价,不是退步。
那个 bug 是什么
原因:逐字投票之前用 lcs() 按拼音把 OCR 的字对齐到 ASR 的句子上。
ASR 写「审判敌人节」(pan)、画面写「神探狄仁杰」(tan)——拼音不同,LCS 配不上这一列,
于是这一列**没有票**,拼回时保留 ASR 的「判」,产出一句两个源都没有的混血句:前半来自 OCR、后半来自 ASR。
修法(原则是“宁可少改,不要错改”):
- 两个对齐锚点之间,如果 ASR 与 OCR 的缺口等长,缺口内逐位投票——拼音不同的字也能被纠正;
- 缺口长度不等(ASR 多字/少字)时整段不投票,并记一条
warn(进result.warns),避免整体串位; - 同名票必须比第二名字多 ≥2 票才采纳(并列或只差一票都不动);
- 判不动的字一律保留 ASR 原文。
修前的逐行结果(留作对照,别当结论)
| 时间 | ASR 原文 | OCR 结果 | 画面实际写的 | 修前判定 |
|---|---|---|---|---|
| 0.4s | 看着棒学着棒学好记住 | 看折棒学折棒学好记住 | 看折棒,学折棒 | 对(改对了人名) |
| 17.4s | 可为什么第三个系列要选审判敌人节呢 | 可为什么第三个系列要选神判狄仁杰呢 | …要选神探狄仁杰呢 | 错(探→判) |
| 36.4s | 但审判敌人节就是能做的成功 | 但神判狄仁杰就是能做的成功 | 但神探狄仁杰就是能做到成功 | 错(探→判,且漏了「到」) |
| 39.2s | 这部剧给大家展现了历史改变剧的上限 | 这部剧给大家展现了历史改编剧的上限 | 这部剧给大家展现了历史改编剧的上限 | 对(逐字一致) |
| 45.0s | 能知道敌人节这个名字 | 能知道狄仁杰这个名字 | 长能知道狄仁杰这个名字士 | 部分对(替换对,首尾两字丢了) |
修后的逐行结果
| 时间 | ASR 原文 | 修后 OCR 结果 | 画面实际写的 | 判定 |
|---|---|---|---|---|
| 0.4s | 看着棒学着棒学好记住 | 看折棒学折棒学好记住 | 看折棒,学折棒 | 对(尾字 ASR 保留) |
| 17.4s | 可为什么第三个系列要选审判敌人节呢 | 可为什么第三个系列要选神探狄仁杰呢 | …要选神探狄仁杰呢 | 对(逐字一致) |
| 36.4s | 但审判敌人节就是能做的成功 | 但神探狄仁杰就是能做到成功 | 但神探狄仁杰就是能做到成功 | 对(逐字一致) |
| 39.2s | 这部剧给大家展现了历史改变剧的上限 | 这部剧给大家展现了历史改编剧的上限 | 这部剧给大家展现了历史改编剧的上限 | 对(逐字一致) |
| 45.0s | 能知道敌人节这个名字 | 能知道狄仁节这个名字 | 长能知道狄仁杰这个名字士 | 半:漏了「杰」(票数不够,宁可不改) |
锁住它的两条回归断言
这两条已经进 scripts/check.mjs(纯函数、不需要 ffmpeg,npm run check 就会跑):
ok  OCR 对账:判→探 一类"拼音不同"的字也能纠正
ok  OCR 对账:两侧字数不等时不串位(多出的「这个」仍在原位)
另外四条真实样本断言(0.4s / 17.4s / 36.4s / 39.2s 的原句与拼音)也一起跑, 其中「看着棒→看折棒」必须仍然改对——防止修 bug 时把原来对的改动一起废掉。
样本很小:只有 1 段 60 秒、5 行被纠正,以上比例仅作参考,不能当总体成功率。
参数也没有美化:MIN_CONF = 0.75(逐字投票)、单字闸门 ≥0.85、
票差 ≥2、简繁归一(zhconv)+ 拼音对齐。OCR 结果默认只是建议,引用前请以画面为准。
要自己看原始像素,这五张是被裁出来对比的字幕条(15% padding、2× 放大):
D:\deepflash\out\ocr-evidence\sub-1-0.4s.png
D:\deepflash\out\ocr-evidence\sub-2-17.4s.png
D:\deepflash\out\ocr-evidence\sub-3-36.4s.png
D:\deepflash\out\ocr-evidence\sub-4-39.2s.png
D:\deepflash\out\ocr-evidence\sub-5-45.0s.png
三步判别法(当时用来确认“画面上到底是探还是判”):连续 3 帧(17.36 / 17.40 / 17.44s)整帧识别都是
神探狄仁杰、conf 1.000;同一条字幕条 LANCZOS 2× 放大后仍是 神探、conf 0.971。
三个尺度、四次识别全部是「探」——所以不是分辨率、不是裁切、不是模型认错。
5. 静态画面提示(不改行为,只提示)
画面几乎不动时,清单里会多出一行,建议重跑参数:
hint: 画面几乎不动(p50=0.00 · p90=0.00,63% 的格子来自积分伪切点)——这类幻灯片/讲课类视频用 integral:false 重跑会更整齐:一格一句话,不再有重复帧。
| 样本 | p50 | p90 | 伪切点段占比 | 是否提示 |
|---|---|---|---|---|
| 静态 PPT 类(120s,6 页) | 0.00 | 0.00 | 62.5% | 出提示 |
| 动作类(testsrc2) | 2.93 | 4.27 | 26.5% | 不出 |
| 真实影视 0–60s | 0.54 | 9.11 | 28.4% | 不出 |
6. 体检表:Python / OCR 三态
服务页体检表现在会多两行,缺什么写什么(不教怎么装,只说用途与可选项)。
| 状态 | Python 行 | OCR 行 |
|---|---|---|
| 就绪 | 可用 · 3.11.18 · …\storyboard\ocr\venv\Scripts\python.exe |
可用 · rapidocr 3.10.0 · onnxruntime 1.31.1 · …\storyboard\ocr\venv |
| 有 Python、没引擎 | 可用 · 3.11.18 | 引擎未就绪 · 缺 rapidocr / onnxruntime |
| 没有 Python | 未找到 · — · 未找到 3.11–3.13(OCR 需要 Python 3.11–3.13) | 不可用 · 安装 OCR 需要 Python 3.11–3.13;可自行安装,或用别的方式装 rapidocr |
| 版本过高(3.15) | 版本过高 · 3.15.0 · 高于 3.13,该版本暂无可用 wheel | 不可用 |
判据是区间 3.11 ≤ v ≤ 3.13:onnxruntime 等编译包只有 cp311/cp312/cp313 的 win_amd64 wheel, 3.14/3.15 装了也跑不起来。
7. token 消耗:钱花在哪
本地跑 ffmpeg / ASR / OCR 不花 token——那些都是你机器上的 CPU。真正花钱的只有两样: 交给模型的图(每张 800×800 的宫格 = 384 tokens,是视觉输入硬上限) 和在场的文字索引(时间码 + 台词)。所以一次 run 的账大致是:
花费 ≈ 分镜图张数 × 384(视觉) + 文字索引字符数 ÷ 2~3(中文粗略折算)同一支视频、同一个 60s 窗口(standard 档、800×800 画布),把两个开关各拨一次:
| 规格 | 张数 | 视觉 tokens | 备注 |
|---|---|---|---|
integral:true(默认) | 4 | 1,536 | 69 帧里 9 个来自伪切点 |
integral:false | 2 | 768 | 58 帧全是真切点,图少一半 |
strategy:"full" | 15 | 5,760 | 每格放大,最贵 |
strategy:"skim"(速览) | 1 | 384 | 全 1/8 档,切点按 0.35s 合并 |
strategy:"brief"(一图) | 1 | 384 | 整段压进一张 |
maxFrames: 24 | 3 | 1,152 | 封顶帧数 |
maxFrames: 12 | 1 | 384 | 封顶 + 并格 |
文字索引这一半基本是“常数”:同一支片子,detail 三档实测长度
| 窗口 | detail=low | detail=med | detail=high |
|---|---|---|---|
| 60s(本页那支) | 8,902 字符 | 8,902 字符 | 8,902 字符 |
| 300s | 16,731 字符 | 16,731 字符 | 16,731 字符 |
| 长台词字幕(合成演示) | 1,675 字符 | 1,692 字符 | 1,692 字符 |
为什么三档一样:detail 的预算是按每格给的(low 60 / med 120 / high 400 字符),
而这支片子的每格台词都短于 60 字,从来没触顶。只有当某一格里有整段朗读(或你塞了长台词 SRT)时
三档才会分开——上表第三行就是那种情况,差距立刻出现。
省钱的四个旋钮,各自都有代价:
| 做法 | 省多少 | 代价 |
|---|---|---|
strategy 往 skim / brief 走 | 4 张 → 1 张(1,536 → 384) | 全部 1/8 档,细节丢;快切被合并成少数几格 |
tierMap 把相邻的快切格压到小档 | 张数不变但每格更小,模型更难读字 | 字变小 / 小字看不清,等于丢内容 |
maxFrames 封顶 | 24 帧 → 3 张(1,152);12 帧 → 1 张(384) | 超出的短镜头直接被并掉,长片尾段可能只剩一格 |
detail:"low" | 每格台词压到 60 字 | 不能引用原话,只能判断“这段在讲什么” |
反过来说,最省的一步不是这些旋钮,是别请求你不需要的时间段:只取 30 秒比你整片跑完再压档便宜得多。
8. 工具说明精简:少占上下文
工具描述(tool descriptions)每轮请求都会常驻上下文。0.9.1 之前五个工具的说明合计
3902 字符、parameters JSON 合计 16287 字符,一大半在讲「为什么这么设计」「举例」
「边界情况」——模型每次开口都要先读一遍。
0.9.2 的做法:每个工具只留 参数清单 + 一句什么时候用(决策线索保留:先 video_probe
再切格、6 格还是 12 格、幻灯片用 integral:false、外语硬字幕用 subtitles:"ocr");
长解释整段搬进 README 的「工具细节」;新增 storyboard_help({topic}) 按主题只取回那一小节。
| 指标 | 0.9.1 | 0.9.2 | 变化 |
|---|---|---|---|
| 五个工具的 description 合计 | 3902 字符 | 1671 字符(含新增 help) | −57% |
| parameters JSON 合计 | 16287 字符 | 15889 字符 | −2.4% |
| 工具数 | 5 | 6 | + storyboard_help |
{ "topic": "storyboard" }   // 参数、engine、transcript
{ "topic": "choose" }       // 该用哪个:probe 先跑、6 格 vs 12 格
{ "topic": "subtitles" }    // ocr / ocr-dense 的区别与代价
可用 topic:storyboard / engine / transcript / subtitles /
detect / precomputed / integral / tier / probe /
locate / zoom / status / choose。取不到的主题会返回可用列表,
不会把整份 README 塞回上下文。